Backend ≠ Harness
Atelier LLM (séance 1)
Modèle, harness et APIComprendre les couches d’un agent IA et le coût de ses appels.
Programme de la séance
1Du modèle à l’agentAppel, boucle, harness, skills et MCP.
2Modèles, accès et coûtsAPI, fournisseurs, prix et cache.
3Installer et utiliserHarness, configuration, mode Plan et sous-agents.
1 : Du modèle à l’agent
Partie 1Le fonctionnement
d’un agent IA.
Du modèle seul au harness
Un appel
→
Prompt systèmeSYSTEM
Tu aides un étudiant.
CONTEXTE
Cours LLM, séance 1.
QUESTION
Explique le cache KV.
→
ModèleUn appel API
→
RéponseDu texte
Une boucle
→
HarnessExécute et vérifie
↔︎
ModèlePropose la suite
Le résultat de l’outil revient au modèle, qui décide de la suite.
Les étapes de la boucle
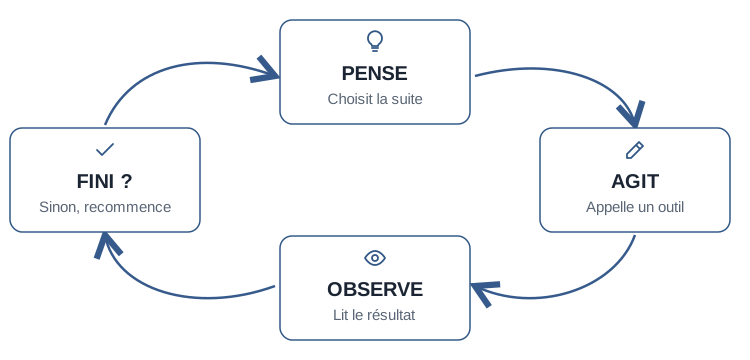
L’exécution des outils
Le modèle demande un appel d’outil. Le harness l’exécute et transmet le résultat au modèle pour le tour suivant.
Exemple : « Corrige le titre de la page d’accueil »
PENSELire le fichier.
→
AGITread(“index.html”)
→
OBSERVE<h1>Accueil</h1>
→
PENSECorriger le titre.
→
AGITedit(“Bienvenue”)
→
FINIRéponse envoyée.
Les instructions d’un skill
name: humanizer
description: Rewrite AI-sounding text so it reads
like the writer without changing what it says.

1. Mark the tells.
2. Draft the rewrite. Keep every supported claim.
   Do not add a fact, name, number, date, quote,
   or citation unless it comes from the source
   or the user.
3. Check the draft. Read it aloud.
   Ask what still sounds AI-generated.
4. Write the final version. State each point
   naturally instead of patching flagged
   phrases one at a time.
Avant
« Cette mise à jour marque un tournant majeur. »
Après
« Cette mise à jour change le fonctionnement du produit. »
skills.sh : registre de skills installables par npx skills add <owner/repo>.
Les commandes d’un serveur MCP
 Wolfram MCP
→
Découvertetools/listNoms et descriptions des commandes.
→
Le modèle choisitla commande adaptée à sa tâche.
Appel choisi : WolframLanguageEvaluatorSolve[x^3 - 6x^2 + 11x - 6 == 0, x]Résultat renvoyé au modèle{{x → 1}, {x → 2}, {x → 3}}
2 : Modèles, accès et coûts
Partie 2Comment accéder aux modèles
et ce que ça coûte.
Les rôles du harness, de l’accès API et du modèle
1Harness
OpenCode, Codex, Claude Code…
Comment travaille l’agent ?
2Accès API
Direct, OpenRouter, Vercel, Cloudflare, OpenCode…
Qui fournit et facture l’appel ?
3Modèle
Astra, Sol, Opus, DeepSeek, Qwen, Muse…
Qui génère les tokens ?
Changer de modèle ne nécessite pas forcément de changer de harness ou de fournisseur d’accès.
Quoi choisir ?
Les résultats des modèles varient selon les tâches évaluées. Les classements publics permettent de comparer leurs performances.
≈ 450 modèlesréférencés en septembre 2026 OpenRouter
≈ 15 nouveautés / moissoit 40 variantes au total en moyenne EpochAI
Les classements changent régulièrement. Consultez plusieurs sources pour comparer les résultats.
Mais à quel prix ?
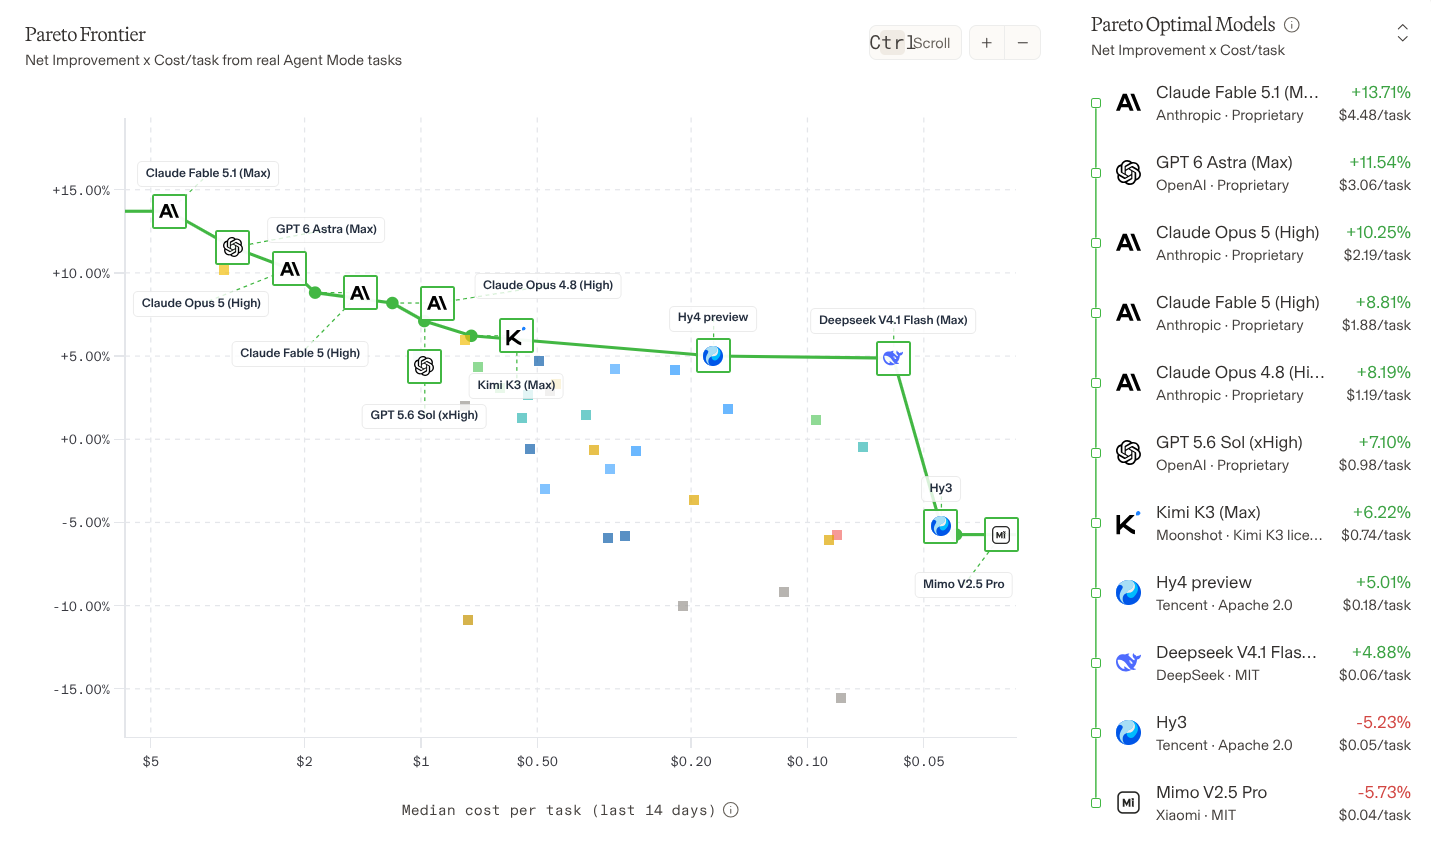
Source : arena.ai — Frontière de Pareto « Net Improvement x Cost/task » d’après les tâches réelles en Agent Mode (coût médian par tâche sur 14 jours).
L’accès : direct, passerelle ou abonnement
Les abonnements sont (presque) toujours plus économiquement rentables.
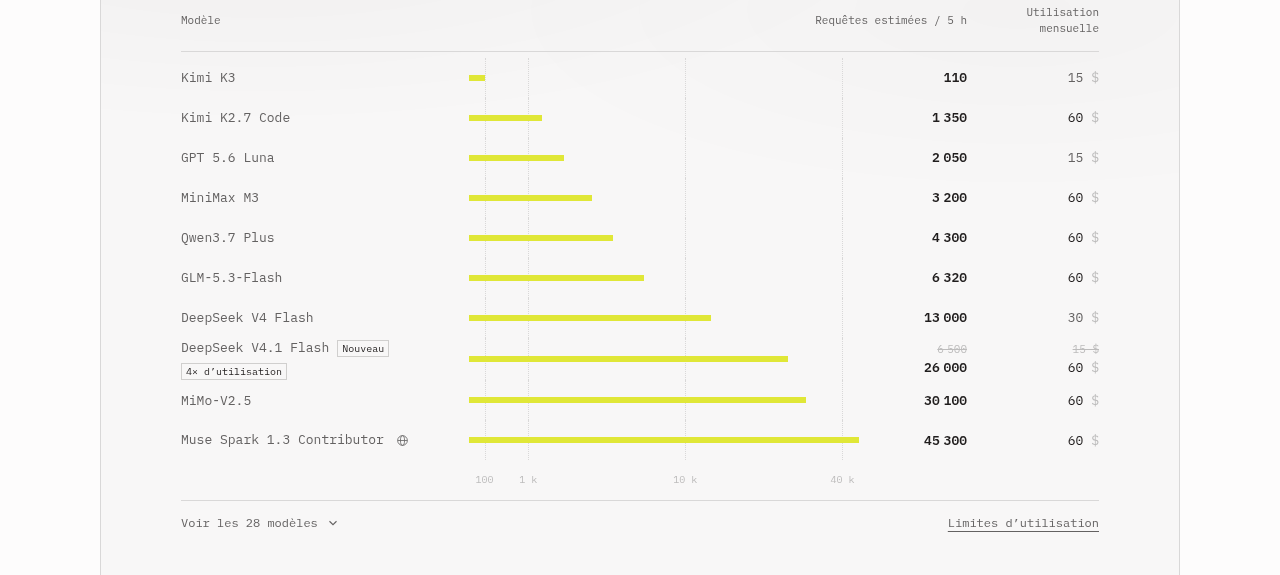
OpenCode Go
10 $abonnement mensuel Go
accès inclus selon le modèle15 $ à 60 $de consommation API équivalente : Kimi K3 ≈ 15 $, Qwen3.7 Plus ≈ 60 $.
Capture recadrée sur les montants affichés par OpenCode Go (septembre 2026). Les montants sont des plafonds d’usage estimés, pas un crédit librement échangeable contre n’importe quel modèle. Détails des limites.
Tarifs des tokens en entrée, en cache et en sortie
$ par million de tokens (prix indicatifs au 21 septembre 2026)
Input : ce qu’on envoie ; Output : ce que le modèle produit.
|
Modèle / accès
|
Input
|
Input en cache
|
Output
|
 GPT-6 Astra OpenAI |
10 $
|
1 $
|
50 $
|
|
GPT-5.6 Sol OpenAI
|
4 $
|
0,40 $
|
20 $
|
 Claude Opus 4.8 OpenCode Zen |
5 $
|
0,50 $
|
25 $
|
 DeepSeek V4.1 Flash direct, heures pleines |
0,30 $
|
0,006 $
|
1,20 $
|
 Qwen3.7 Max OpenCode Zen |
2,50 $
|
0,50 $
|
7,50 $
|
 Kimi K3 OpenCode Go |
3 $
|
0,30 $
|
15 $
|
 Muse Spark 1.3 OpenCode Zen |
1,25 $
|
0,15 $
|
4,25 $
|
|
Muse Spark Contributor Zen (temporaire)
|
0 $
|
0 $
|
0 $
|
Sources : OpenAI, DeepSeek, OpenCode Zen, OpenCode Go. Tarifs variables selon contexte, horaires, option de cache et fournisseur.
Pourquoi le cache coûte-t-il si peu ?
À chaque couche, le cache conserve les K et V des tokens déjà traités pour éviter de les recalculer.
Le mécanisme d’attention dans un Transformer
\[\operatorname{Attn}(Q,K,V)=\operatorname{softmax}(S)\,V,\qquad S=\frac{QK^{\top}}{\sqrt{d_k}}+\underbrace{M}_{\text{masque causal}}\]
Le modèle traite le texte reçu
Le modèle calcule Q, K et V pour les tokens du texte.
→
Le modèle garde K et V
Ces informations restent en cache à chaque couche du modèle.
→
Le modèle poursuit la réponse
Le modèle réutilise les K et V précédents et ajoute ceux du token qu’il vient de traiter.
Le cache KV évite de refaire des calculs pendant la réponse. Le prompt caching permet de réutiliser ces calculs d’une demande à l’autre, pour un même début de texte.
L’intérêt du cache
Le prompt caching permet de réutiliser les calculs d’un même début de prompt entre plusieurs requêtes.
Requête 1Votre document de 20 pages« Résume-le. »
Requête 2Le même document, au même endroit« Quels sont les risques ? »
Un objectif : maximiser le « cache hit ».
La partie commune peut être réutilisée. Si le fournisseur reconnaît ce préfixe et le conserve encore en cache, les tokens correspondants peuvent être facturés au tarif « input en cache ».
3 : Installer et utiliser
Partie 3Installation et utilisation
d’un harness.
Installer un harness
Coller la commande dans le terminal.
OpenCode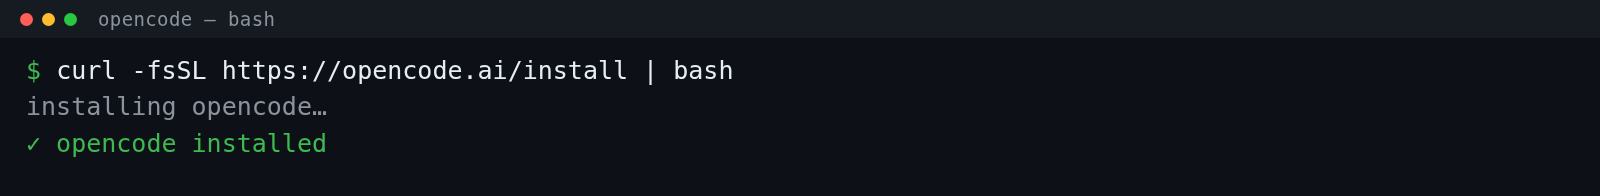
Claude Code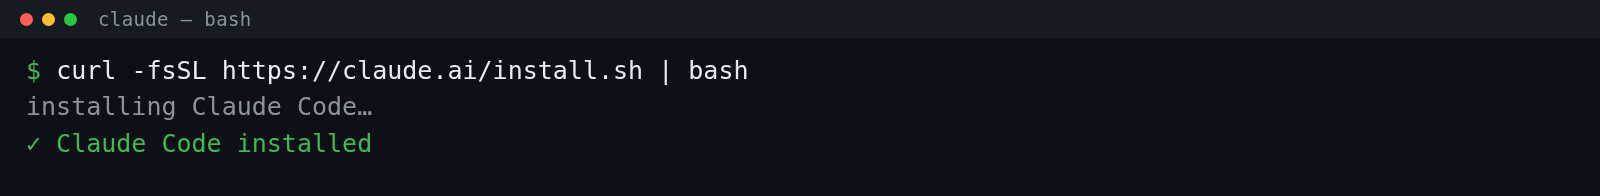
Codex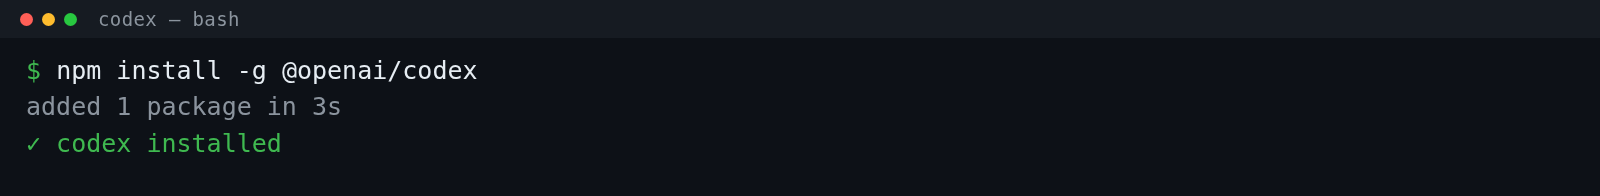
Chaque harness propose sa propre commande d’installation. Une fois installé, il se lance depuis le terminal.
Mode Plan
Définir les étapes du travail
L’agent recherche les informations et propose un plan. Il vous pose des questions pour préciser la demande, puis attend votre validation pour l’exécuter.
1 Chercher des sources sur Internet2 Proposer un plan3 Vous poser des questions4 Exécuter après votre validation
Exemple : préparer cette présentation
« Compare les tarifs officiels de trois fournisseurs et propose un plan de diapositives. Demande-moi le public visé et le niveau de détail avant de les créer. »
Sous-agents
Répartir le travail
L’agent principal confie une mission précise à d’autres agents. Chacun travaille de son côté, puis lui transmet ses résultats.
Un agent rechercheIl trouve les informations utiles.
Un autre vérifieIl contrôle les sources et les chiffres.
L’agent principal rassembleIl prépare une réponse commune.
Exemple : comparer les abonnements IA
« Confie à trois sous-agents les offres d’OpenAI, d’Anthropic et de Google. Chacun relève les prix et les limites sur le site officiel. Rassemble ensuite leurs résultats dans un tableau avec les liens. »
En pratique !
Passons à la pratiqueEn pratique !
 OpenCode
 Cursor
 Claude Code
 Copilot
 Kilo Code
 Cline
 Pi
 Oh My Pi
 ZCode
 Grok Build
 Hermes
 Gemini
 Mistral
 MiniMax
 GLM
 MiMo
 Grok
 OpenRouter
 Vercel
 Cloudflare